OpenTWBench
Open Taiwan Benchmark(非營利組織)117
GitHub 星數
測 AI 懂不懂台灣:25 萬題國考題加上台灣生活題的公開評測
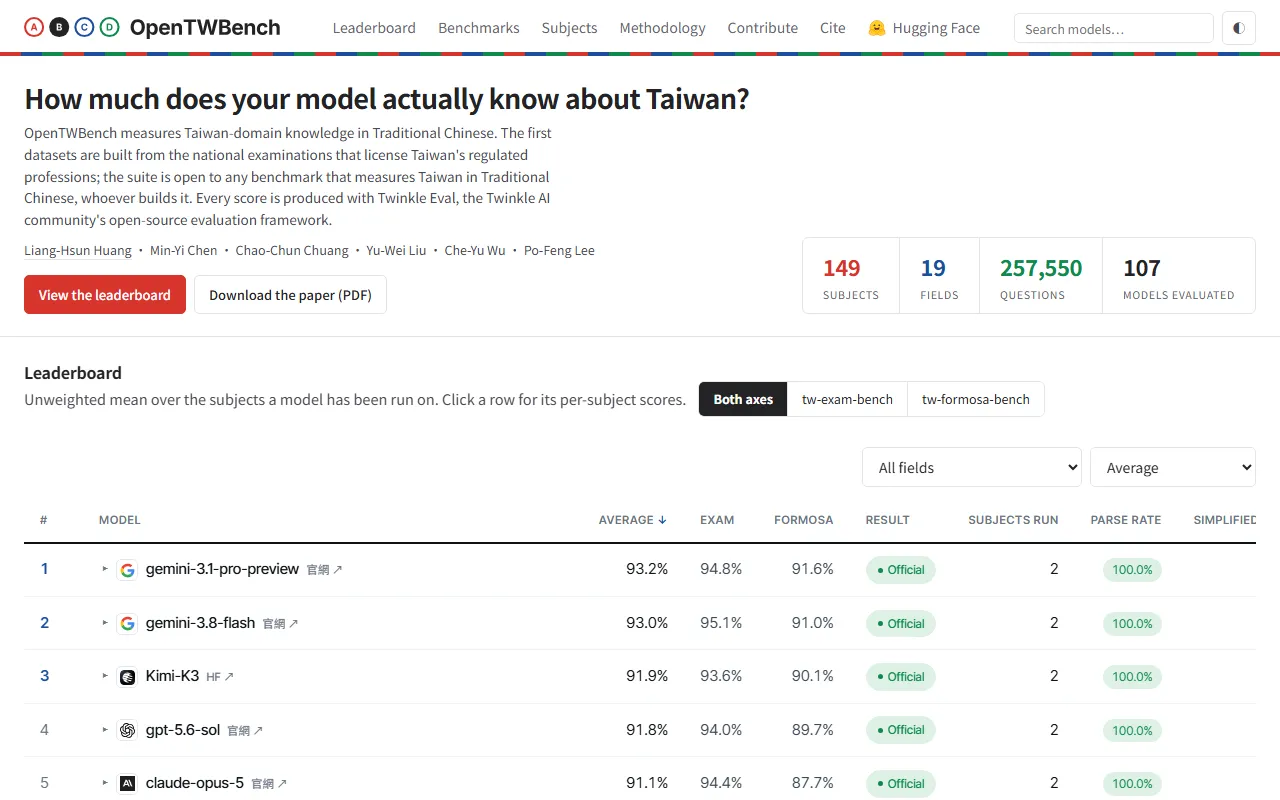
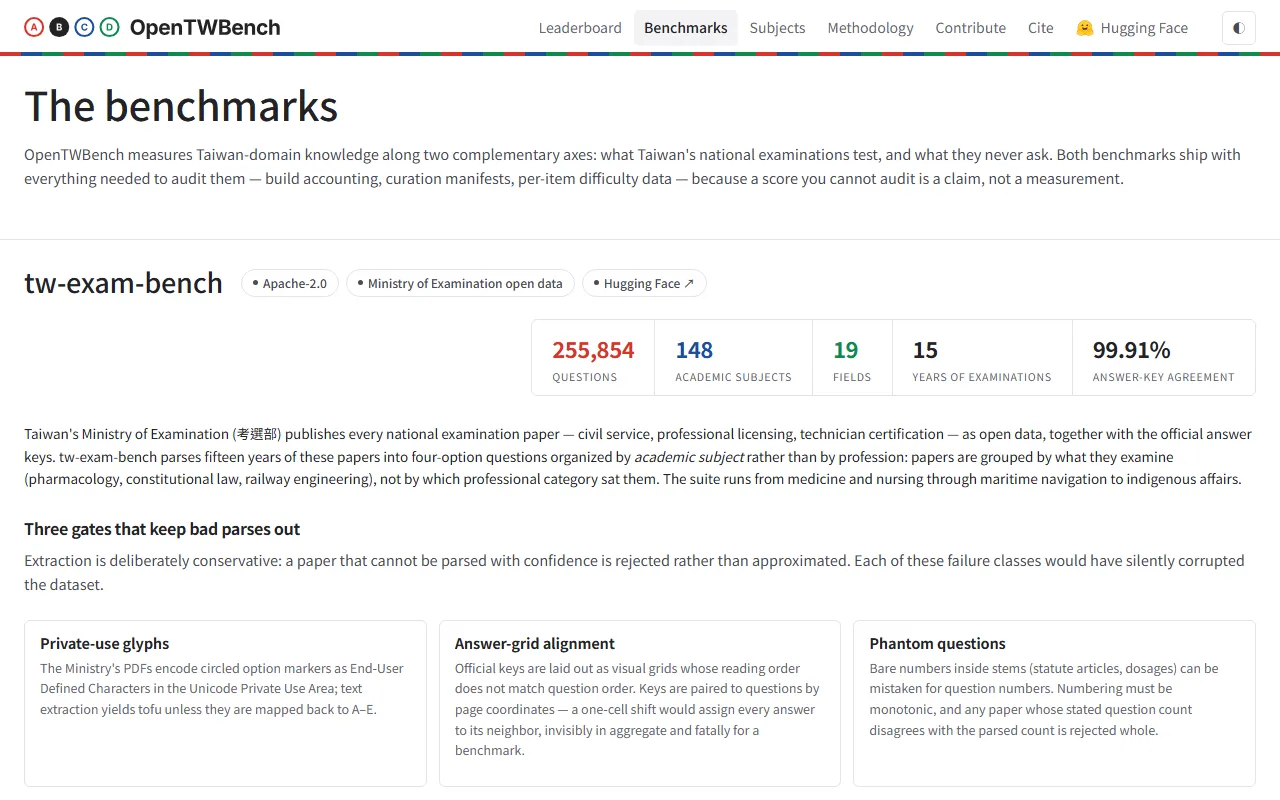
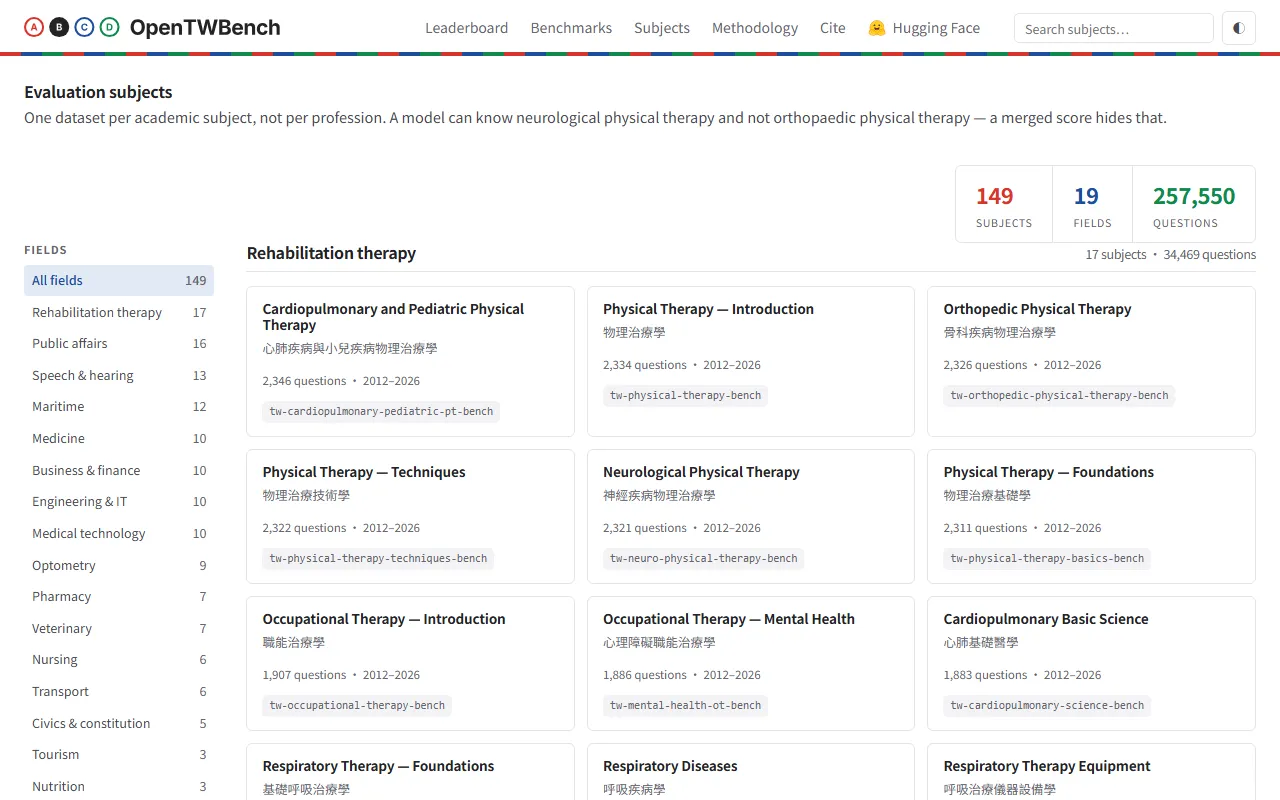
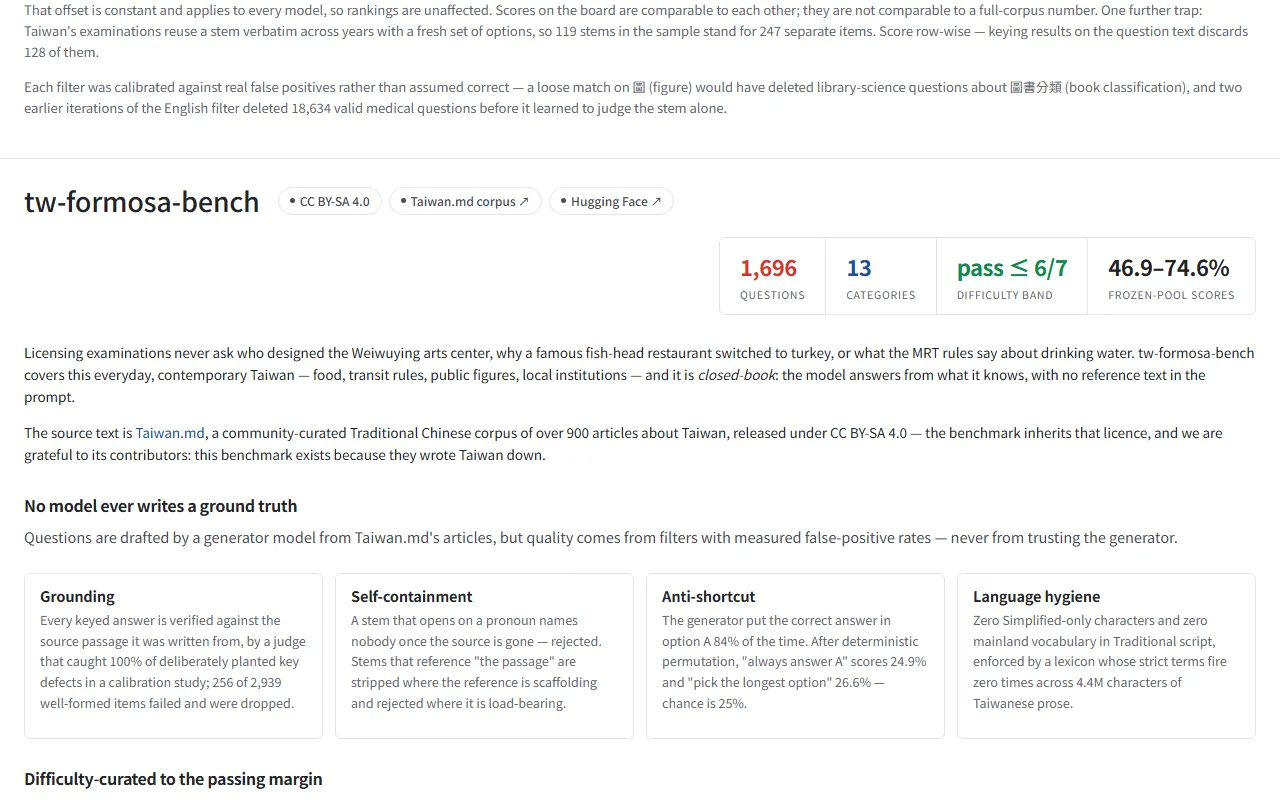
測試大型語言模型對台灣知識掌握程度的公開評測。tw-exam-bench 收錄 255,854 題國家考試題、148 個科目;tw-formosa-bench 是 1,696 題台灣生活題。網站上有 107 個模型的排行榜。
研究與評測有公開原始碼
值得一提
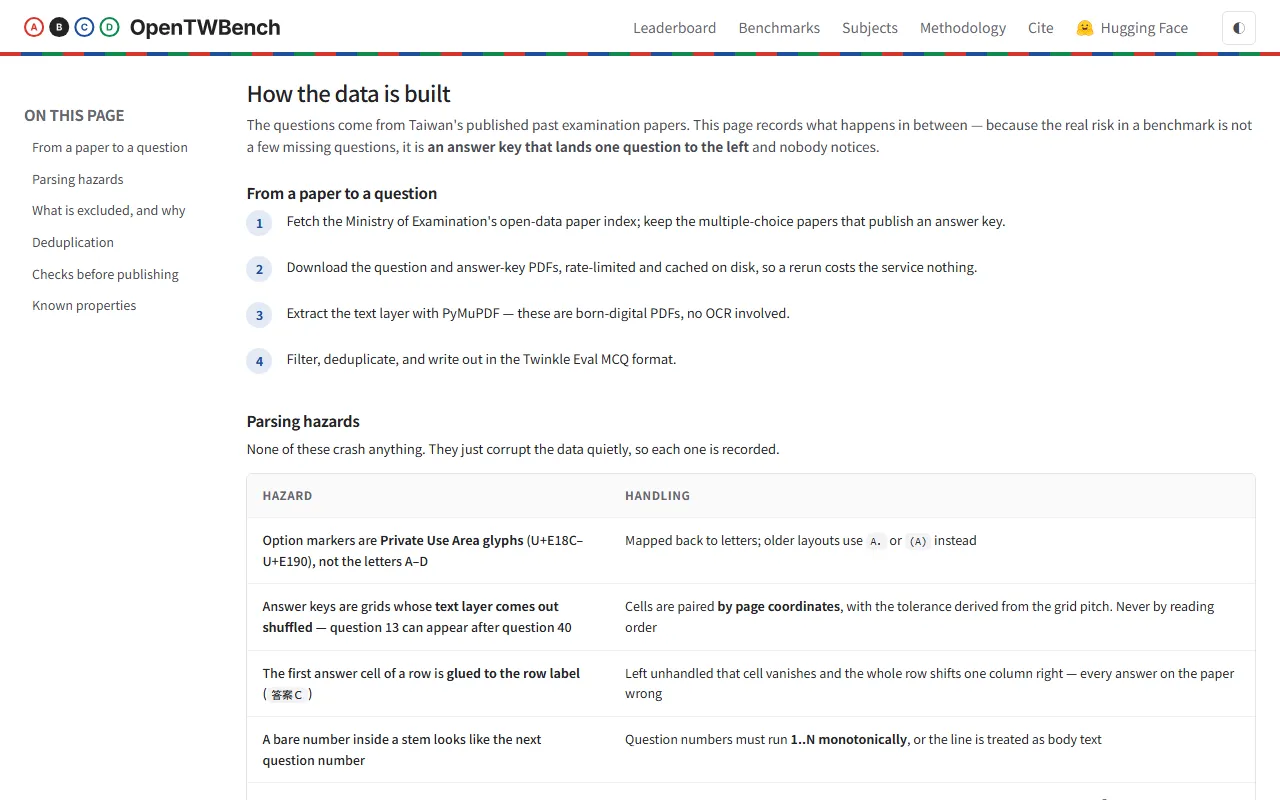
- 從 629,343 筆原始題目篩到 255,854 題,每一步排除都有計數。
- 團隊的研究指出:換一種從答案裡擷取選項的方式,同一個模型的分數可以從 20.8% 變成 93.9%。
使用前要知道
- 排行榜使用 22,021 題的抽樣,比全部題目的分數低約 2 個百分點。
- 國考題是公開的考古題,模型可能在訓練時就看過,團隊自己也提醒了這點。
- 網站上的 GitHub 連結目前打不開,題庫放在 Hugging Face。
- 授權
- tw-exam-bench:Apache-2.0;tw-formosa-bench:CC BY-SA 4.0;Twinkle Eval:MIT
- Repo
- ai-twinkle/Eval
- 星數
- 117
- 建立
- 2025-03-31
- 最後更新
- 2026-09-15
- commit 數
- 132
- 有提交的天數
- 31 天
- 更新型態
- 一年半穩定維護(評測工具 Twinkle Eval)
GitHub 數字查詢於 2026-10-16,來源為 GitHub API。
討論
讀取中
相似作品
收錄頁內容由島作整理自作品公開的程式碼、文件與網站(查證日期 2026-10-13)。我們沒有安裝或長時間實測。介紹由作者更新於 2026-10-16。